
LAION-5B 資料集是一個大型的公開圖像-文字配對資料集,內容包含從網路上獲取的圖像-文字配對。此資料集是由德國非營利組織 LAION 建立,除了 LAION-5B 之外,也曾發布 LAION-400M 資料集。這些資料集被廣泛用於訓練各種 AI 模型,特別是文字到圖像生成模型。
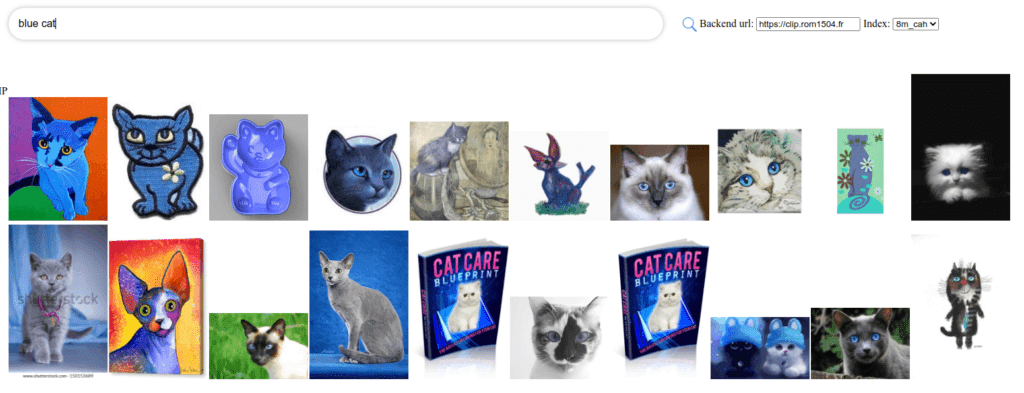
Image: LAION
LAION-5B 資料集的特點:
- 超過 58.5 億個圖像-文字配對 1,比其他公開的英文圖像-文字資料集大 20 多倍。
- 資料集中的圖像和文字描述來自 Common Crawl,這是包含數十億個公開網頁資料的資料庫。
- 資料集中包含 23.2 億個英文圖像-文字配對,22.6 億個多語言圖像-文字配對(涵蓋 100 多種語言),以及 12.7 億個未指定語言的樣本(例如地點、產品名稱等)。
- CLIP 過濾:為了確保資料集的品質,LAION 使用 OpenAI 的 CLIP 模型對圖像-文字配對進行過濾。 CLIP 是一個嵌入向量的演算法,可以來判斷圖像和文字描述是否相關。 只有當相似度超過閾值時,才會將樣本添加到 LAION-5B 資料集中 2。
- 有害內容: 雖然 LAION 有採取措施過濾有害內容,但仍可能存在色情、暴力或仇恨言論等不適當或非法的圖像。 LAION 不會從 LAION-5B 中移除這些內容,而是使用標籤標記這些內容,以便研究人員自行決定是否使用。 據報導,有一個內部分類器可以捕捉 96.45% 的不適當圖像。
- 著作權: LAION-5B 資料集中的圖像來自網際網路,因此可能存在著作權問題。 LAION 認為由於自己沒有託管圖像,只是提供指向公開圖像的連結,因此不會造成著作權侵權。
- 資料保護: LAION-5B 資料集中可能包含私人圖像,例如醫療記錄或其他敏感資訊。 如果圖像違反了 GDPR,使用者可以直接向 LAION 申請移除。 原創作者可以查看 https://haveibeentrained.com 網站,確認他們的照片和藝術作品是否被包含在資料集中。
- LAION-5B 資料集已被用於訓練許多知名的圖像模型,包括 Midjourney、 Stable Diffusion 和 Google Brain 的 Imagen 等。
- 據媒體報導,以下公司與 LAION 有所關聯:
- Stability AI:資金贊助,並用以訓練自己的 Stable Diffusion 模型。 - Doodlebot:資金贊助。 - Hugging Face:資金贊助,也在其平台託管 LAION-5B 資料集。